AI 迷你超级计算机ASUS Ascent GX10
以 NVIDIA DGX Spark™ 为基础
ASUS Ascent GX10 迷你超级计算机结合 NVIDIA GB10 Grace Blackwell 超级芯片与 NVIDIA AI 软件堆栈的强大算力,为 AI 开发和部署提供全方位的解决方案。其精巧的设计有助于无缝整合与部署,为追求出色的创新者提供强大的 AI 性能。借助先进的 AI 工具和 NVIDIA® ConnectX®-7,这款小型服务器不仅能提升您的 AI 能力,更能助您打造独特的解决方案。


-

NVIDIA® GB10 Grace Blackwell 超级芯片
-
高达
128GB 统一内存
提供 64GB 和 128GB 两种规格配置可供选择
-
1 petaFLOP
AI 算力
-

-
NVIDIA®
NVLink™-C2C提供一致的 CPU+GPU 内存模型,带宽高达 PCIe Gen 5 的五倍
-
NVIDIA DGX™ OS 及 Ubuntu Linux
-
NVIDIA® ConnectX®-7
可串接两台 GX10 系统,处理更庞大的模型
-
优化散热设计
-
NVIDIA AI 软件堆栈
-
AI 开发环境
包含 NVIDIA NIM™ 和 Blueprints。支持 Pytorch、Jupyter、Ollama 进行原型设计和推理
video about ASUS Ascent GX10 | ASUS AI Supercomputer
设计
将革命性 AI 性能带至您的桌面
ASUS Ascent GX10 AI 迷你超级计算机,采用 NVIDIA DGX Spark 所搭载的 NVIDIA® GB10 Grace Blackwell 超级芯片,将 petaFLOP 等级的 AI 算力直接带给开发人员、AI 研究人员和资料科学家。这款创新设备凭借其出色的性能和先进功能,专为强化本地 AI 开发而设计。
精巧、强大且可扩展
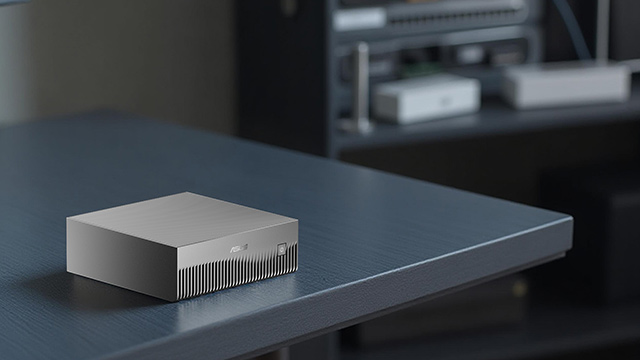
精巧尺寸 150 x 150 x 51mm

出色的 AI 算力
使用 FP4 精准度时,AI 算力高达 1 petaFLOP
提供高达 1 petaFLOP 的 AI 算力,为大型 AI 工作负载提供强大动力
64GB 或 128GB LPDDR5x 一致性统一系统内存
凭借充足的内存容量,赋予模型开发、实验和推理更强大的能力
-
高达
1 petaFLOP
AI 算力
(使用 FP4) -
高达
128G
一致性统一
系统内存
先进的架构
NVIDIA GB10 Grace Blackwell 超级芯片:
作为 ASUS Ascent GX10 的核心,这款先进芯片配备强大的 Blackwell GPU,搭载第五代 Tensor Core 并支持 FP4。
性能 20 核心 Arm CPU:
强化数据预处理与调度,加速模型微调和实时推理。
NVLink™-C2C 技术:
提供一致的 CPU+GPU 内存模型,带宽高达 PCIe 5.0 的五倍。


性能
驾驭大型参数生成式 AI 模型
支持高达 2000 亿参数的 AI 模型
直接在桌面上完成最新 AI 推理模型的原型设计、微调及推理——64GB 配置可运行高达 1000 亿参数的模型,128GB 配置更可扩展支持高达 2000 亿参数的模型。
集成 NVIDIA® ConnectX®-7 网络技术
可通过 NVIDIA Sync 将最多四台系统组成集群,以获得更大的统一内存池(64GB 配置机型集群可达 256GB,128GB 配置机型集群可达 512GB)以及高达 4 petaFLOPS 的算力,轻松运行前沿大模型与更复杂的智能体(Agents)。
AI 网络
迎接新一代连接能力:NVIDIA® ConnectX-7
ASUS Ascent GX10 整合 NVIDIA® ConnectX-7,提供超高速网络,实现分布式 AI 工作负载间的快速数据传输和低延迟通讯。

U超高速 AI 数据吞吐量
超快的带宽确保节点之间的快速数据传输,适合大规模分布式 AI 工作负载。

安全、智能的网络
内置的 TLS、IPsec 和 MACsec 硬件加速功能,确保数据加密传输,而无需占用 CPU 资源。

高精准度的关键性能
IEEE 1588v2 PTP 支持实现微秒级的时间同步,适用于对时间敏感的 AI 和边缘计算应用。
AI 体验
整合式 AI 软件堆栈,实现无缝开发体验

预载 AI,即刻开发
NVIDIA DGX OS (基于 Ubuntu) – 优化的 AI 环境,开箱即用。
NVIDIA AI 软件堆栈 – 预载框架、SDK 和工具,实现快速部署。

优化的 AI 工具与框架
CUDA、PyTorch、TensorFlow、Jupyter – 专为 AI 模型开发与推理优化。
NVIDIA TensorRT – 高性能 AI 推理引擎。
NVIDIA NIMs & Blueprints – 预建的 AI 工作流程与微服务。

先进的 AI 模型支持
DeepSeek R1 —— 针对高达 100B(1000 亿)参数的 AI 推理进行了深度优化,是 64GB 机型配置的理想之选。
生成式 AI — 支持高达 512GB 共享内存池的前沿超大模型(通过 NVIDIA Sync 实现 4 台 GX10 128GB 机型集群)。
Meta、Google 等前沿模型 —— 广泛兼容业界领先的主流 AI 框架。
Agentic AI
借助 NVIDIA NemoClaw 实现安全且可扩展的智能体 AI
搭载 NVIDIA NemoClaw 开源软件栈的 ASUS Ascent GX10,为 OpenClaw 增添了隐私和安全控制功能。NemoClaw 安装 NVIDIA OpenShell 以强制执行基于策略的隐私和安全防护措施,使用户能够控制代理的行为和数据处理方式,并提供计算资源以在本地运行 NVIDIA Nemotron 等开源模型,从而增强隐私保护并提高成本效益。
在 GitHub 上查看 立即体验
本地驱动智能体 AI,告别无休止的 Token 费用
华硕 Ascent GX10 具备 1 petaFLOPS 的 AI 算力以及 64GB 或 128GB 内存,让您能够按需运行智能体 AI(Agentic AI,例如 OpenClaw1 或其他框架)。通过在本地部署并运行您青睐的 AI 模型,您可以实现更高的成本可预测性2、企业级稳定性,并进一步防范意外的数据泄露风险3。
• 7×24 小时不间断 AI 运行
• 降低对云端 API 的依赖
• 本地化数据自主权
免责声明
- 华硕 Ascent GX10 支持并兼容各类第三方开源软件,如 OpenClaw、Hermes Agent 等。
OpenClaw 为其各自所有者的商标/产品。 - “降低 API 依赖”是指直接利用华硕 Ascent GX10 的板载硬件在本地运行开源模型(如 Llama、Qwen 等)。若使用第三方服务、高级付费授权模型或基于 Web 的插件,可能仍会由相应提供商另行收取费用。文中所述节约 API Token 费用的说明仅作示意参考,实际效果取决于用户具体的工作流及所选择的本地开源模型。华硕不提供任何第三方专有模型的 API 密钥或许可证。用户须自行负责并确保遵守所部署的任何 AI 模型及集成至 OpenClaw 或其他框架中的第三方软件的服务条款。
- 若配置了网络访问或第三方服务,仍可能存在数据泄露风险。本声明基于未启用任何外部端点的默认本地配置得出。
NVIDIA 个人 AI 路由器 (PAIR)
借助 NVIDIA® PAIR 打造专属个人 AI 网络
借助 NVIDIA® PAIR(Personal AI Router,个人 AI 路由器),华硕 Ascent GX10 可成为您专属个人 AI 集群的核心枢纽——通过单一端点,将推理请求调度至您名下的每一台 RTX GPU、Mac 和 Windows PC。这有助于最大限度释放本地算力,同时确保提示词(Prompts)、文件及智能体上下文(Context)严格私密保密,无需往返上传至云端。
立即下载
散热
精密打造,实现高效散热效率
ASUS Ascent GX10 助您驾驭严苛的AI工作负载。其先进的双风扇设计配备7级风速调节,实现流畅精准的气流控制。相比同类紧凑型系统,GX10 的散热覆盖效率提升1.6倍,保持更低温度,持续发挥巅峰性能。
灵活扩展
轻松堆叠,AI 算力成倍飞跃

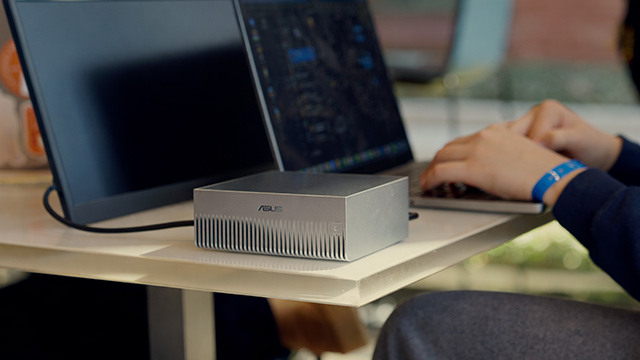
两台 64GB 机型可聚合成 128GB 内存池,并提供高达 2 petaFLOPS 的 AI 算力——性能可达单台 128GB 机型的 1.7 倍,且完全无需服务器机架。
两台 128GB 机型可汇聚成 256GB 内存池;若进一步扩展至四台,即可拥有 512GB 内存与高达 4 petaFLOPS 的 AI 算力,足以运行前沿超大模型与更复杂的智能体(Agents)。借助 NVIDIA Sync,系统集群的搭建与管理变得轻而易举。*
*四台系统组建集群需搭配外接交换机。
资料来源:NVIDIA Sync — 集群助手、通过交换机连接多个 DGX Spark
连接能力
I/O 接口


1Kensington 安全锁槽
21 x USB 3.2 Gen 2x2 Type-C,20Gbps,
支持替代模式 (DisplayPort 2.1),具备 PD 输入 (180W EPR PD3.1 规范)
33 x USB 3.2 Gen 2x2 Type-C,20Gbps,
支持替代模式 (DisplayPort 2.1)
4HDMI 2.1b 接口
510 GbE LAN
6NVIDIA ConnectX®-7 NIC
应用
本地开发,灵活部署

无缝转移至云端
利用 NVIDIA AI 平台软件架构,只需微调程序代码,即可将模型从桌面环境转移至 DGX Cloud 或任何加速的云端或数据中心基础架构。
具成本效益的实验平台
释放丛集中更适合用于训练和部署生产模型的宝贵计算资源。

原型设计

微调/推理

资料科学
常见问题
-
华硕 Ascent GX10 提供哪些内存规格配置?华硕 Ascent GX10 提供哪些内存规格配置? 华硕 Ascent GX10 提供 64GB 或 128GB 的一致性统一系统内存,为不同规模的 AI 开发、实验与推理工作负载提供灵活的选择。
-
ASUS Ascent GX10 包含哪些软件和工具?ASUS Ascent GX10 包含哪些软件和工具? Ascent GX10 预装 NVIDIA AI 软件堆栈,开发者可以使用 PyTorch、TensorFlow、JAX、Ollama 等框架。NVIDIA AI 软件堆栈还允许用户在系统上运行开源模型。
-
可以将多个 Ascent GX10 聚集在一起以获得更大的 AI 模型容量吗?可以将多个 Ascent GX10 聚集在一起以获得更大的 AI 模型容量吗? 对于更大规模的 LLM 微调或高性能模拟和科学计算,有时您可能需要扩展 Ascent GX10 设备的工作负载。最多可将四台 GX10 集群在一起,以将工作负载扩展到单台设备之外。使用集成的 NVIDIA ConnectX-7 网络技术来实现集群。
-
Ascent GX10 和 NVIDIA DGX Spark 之间的主要区别是什么?Ascent GX10 和 NVIDIA DGX Spark 之间的主要区别是什么? 华硕 Ascent GX10 展现了精湛的工程设计,其散热设计旨在轻松应对高负荷工作。其散热系统的每个部件都体现了精湛的工艺,确保在令人印象深刻的紧凑外形中持续提供高性能。
-
Ascent GX10 支持哪些 AI 应用?Ascent GX10 支持哪些 AI 应用? Ascent GX10 支持广泛的 AI 工作负载。在生成式 AI 领域,它能够为高级聊天机器人和虚拟助手微调和运行大型语言模型 (LLM)。此外,它在计算机视觉任务(例如物体检测和追踪)以及用于风险评估和需求预测的预测分析方面也表现出色。此外,GX10 非常适合模拟和研究,使其成为适用于多个行业的多功能 AI 计算解决方案。
-
我可以将 Ascent GX10 用于教育吗?我可以将 Ascent GX10 用于教育吗? 华硕 Ascent GX10 拥有高达 1 petaFLOP 的 AI 性能,为机构、教育工作者和学生提供亲身体验 AI 训练、模型微调以及部署大规模 AI 模型的机会。用户现在可以在校园内进行模型原型设计和实验,而不再仅仅依赖于云端资源。
-
我可以将 Ascent GX10 用于企业吗?我可以将 Ascent GX10 用于企业吗? Ascent GX10 是一款紧凑型 AI 超级计算机,它支持本地 AI 工作负载,避免重复的云计算成本,同时确保数据机密性,从而消除了高性能 AI 计算的障碍。它采用紧凑的 1.6L 机身设计,可轻松融入标准办公环境。无论您身处制造、零售、金融、医疗保健还是科技领域,Ascent GX10 都能帮助您更快地获得洞察并高效运营。
-
ASUS Ascent GX10 包含哪些保修服务?ASUS Ascent GX10 包含哪些保修服务? 中国大陆地区销售的 ASUS Ascent GX10 提供 3 年有限硬件保修,涵盖自购买之日起的材料和工艺(或制造)缺陷。
-
ASUS Ascent GX10 能运行 OpenClaw 吗?ASUS Ascent GX10 能运行 OpenClaw 吗? 是的,ASUS Ascent GX10 是一款紧凑型 AI 超级计算机,可提供高达 1 petaFLOP 的 AI 性能和 128GB 的统一内存,足以应对大规模工作负载。它支持 OpenClaw 和 Hermes Agent 等代理型 AI 框架,能够构建完全本地化的 AI 系统,并具备可预测的成本、企业级的稳定性以及安全的数据隐私保障。
-
64GB 与 128GB 版本的 Ascent GX10 有什么区别?我应该如何选择?64GB 与 128GB 版本的 Ascent GX10 有什么区别?我应该如何选择? 64GB 配置支持高达 1000 亿参数的模型——能够以更实惠的售价,完全在设备端轻松运行当下最热门的 30B–35B(300亿至350亿)参数级智能体模型。128GB 配置则支持在本地运行高达 2000 亿参数的模型,适合需要构建更大规模或微调模型的团队。两款机型均采用相同的 NVIDIA GB10 Grace Blackwell 超级芯片,并具备 1 petaFLOPS 的 AI 算力;二者也均可通过 NVIDIA Sync 与更多机型(最多四台)组建集群,以实现内存与算力的汇聚共享。